
- Published on
Чотири властивості мовних моделей, які пояснюють їхні помилки
- Автори
- Name
- Екклезіаст
- github

Розробник просить модель підказати, як у маловідомій бібліотеці увімкнути суворий режим валідації. Відповідь виглядає бездоганно: назва параметра, приклад конфігурації, посилання на сторінку документації. Параметра не існує, а посилання веде на 404.
Легко списати це на «модель знову галюцинує» і перейти до наступного запиту. Але така реакція нічого не дає: наступного разу помилка повториться в іншій формі, і ви знову помітите її запізно. Корисніше розуміти, звідки береться саме ця помилка. Тоді стає зрозуміло, де відповіді можна довіряти, а де її треба перевіряти ще до того, як вона потрапить у код.
У курсі Anthropic «AI Capabilities and Limitations» поведінку генеративних моделей пояснюють через чотири властивості: передбачення наступного токена, знання, робочу пам'ять і керованість. Кожна з них має свою зону можливостей і свою зону обмежень. А більшість реальних збоїв виникає на їхньому перетині.
Звідки береться асистент
Перш ніж говорити про властивості, варто розібратися, як модель стає співрозмовником. Цей процес має два етапи, і кожен залишає в поведінці моделі свій слід.
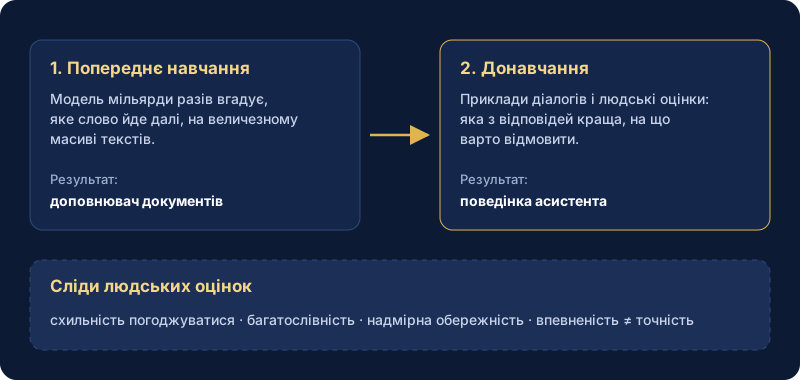
Попереднє навчання (pretraining). Модель знову і знову вгадує наступний фрагмент тексту на величезному масиві даних. Після цього етапу вона вміє продовжувати документи, але не має уявлення про те, що таке допомагати. Якщо дати такій моделі рядок «Яка столиця Франції?», вона цілком може продовжити його ще кількома питаннями, ніби перед нею список питань для вікторини.
Донавчання (fine-tuning). Поверх доповнювача документів формують поведінку асистента: сприймати текст як запит, відповідати, а не продовжувати, відмовляти у шкідливих проханнях. Для цього використовують приклади діалогів і людські оцінки: з двох відповідей обирають кращу, і модель вчиться давати такі, що частіше подобаються людям. Найвідоміший варіант цього підходу — навчання з підкріпленням на основі людського зворотного зв'язку (RLHF).
Людські оцінки залишають характерні сліди:
- Схильність погоджуватися. Люди частіше ставлять високі оцінки відповідям, які збігаються з їхньою думкою. Дослідники з Anthropic показали, що і люди, і моделі, навчені на їхніх уподобаннях, іноді віддають перевагу переконливій згоді перед правильною відповіддю. Тому модель може «передумати» лише через те, що ви наполягли.
- Багатослівність. Розгорнута відповідь виглядає старанніше, тож модель тяжіє до довгих пояснень навіть там, де вистачило б одного речення.
- Надмірна обережність. Відмова в безпечному проханні або зайві застереження — побічний ефект навчання відмовляти в небезпечних.
- Слабке калібрування. Упевнений тон відповіді погано пов'язаний з її надійністю. Модель однаково рівно формулює і добре відомий факт, і щойно вигадану деталь.
Ці сліди не є вадами конкретного продукту. Це наслідок того, як модель навчали, і саме тому їх корисно мати на увазі під час будь-якої роботи з нею.
Шкали, а не список недоліків
Кожну з чотирьох властивостей зручно уявляти як шкалу. На одному кінці завдання, з якими модель справляється надійно, на іншому ті, де вона систематично помиляється. Ваша задача — зрозуміти, де саме на кожній шкалі опиняється конкретний запит.
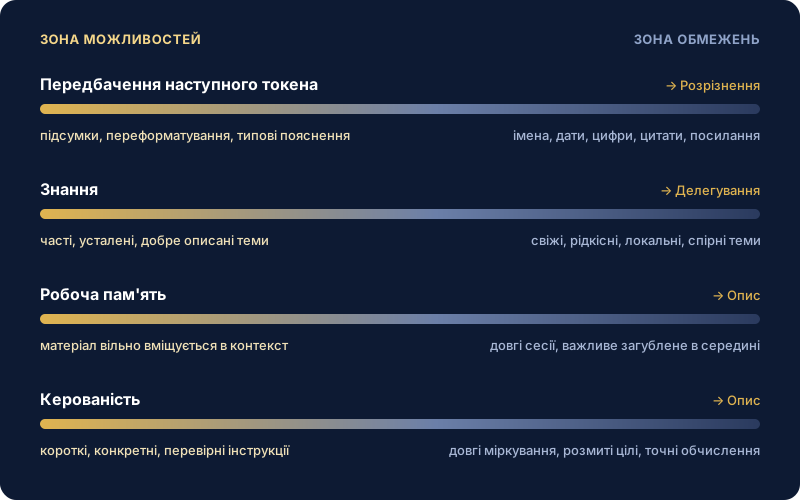
Праворуч на схемі видно зв'язок із фреймворком 4D з курсу Anthropic про AI Fluency, на який спирається і цей курс. Фреймворк описує чотири компетенції людини в роботі з ШІ: делегування (Delegation) — що доручати моделі, опис (Description) — як формулювати завдання, розрізнення (Discernment) — як оцінювати результат, і сумлінність (Diligence) — як відповідально використовувати отримане. Властивості моделі пояснюють, навіщо кожна з цих компетенцій потрібна.
Передбачення наступного токена
Генеративна модель пише відповідь фрагмент за фрагментом, щоразу обираючи найправдоподібніше продовження з огляду на все, що вже є в тексті. Як модель розбиває текст на ці фрагменти (токени), розказано в статті «Що таке генеративний ШІ».
Зона можливостей — завдання, схожі на шаблони, які модель бачила багато разів: підсумувати текст, змінити формат, пояснити поширене поняття, написати типовий код.
Зона обмежень — нові або рідкісні території і все, де треба відрізнити «правдиве» від «правдоподібного». Модель оптимізує саме правдоподібність. Здебільшого ці дві речі збігаються, але гарантії такого збігу немає.
Вигадки концентруються в конкретиці: імена, дати, статистика, цитати, номери версій, назви параметрів, посилання. Що точніше твердження, то більше воно потребує перевірки. Загальне пояснення того, як працює кешування, найімовірніше буде правильним. Конкретна назва опції кешу в конкретній версії бібліотеки — вже ні.
Посилання на джерела у відповідях, позначення невпевненості, генерація за жорсткою схемою і зв'язки «генератор — перевіряльник» існують саме для того, щоб відсунути цю межу. Але вони її не скасовують.
Ця властивість лежить в основі розрізнення. Знаючи, що відповідь згенеровано, а не знайдено, ви знаєте, яку саме перевірку застосувати.
Знання
Усе, що модель «знає», вона взяла з навчальних даних, і ці знання застигли в момент knowledge cutoff — дати, на якій зібрали дані для навчання. Без інструментів модель нічого не знає про події, релізи й зміни після цієї дати.
Зона можливостей — теми, які в даних траплялися часто, послідовно і не надто давно відносно дати зрізу.
Зона обмежень — рідкісне, свіже, нішеве, локальне або спірне. Сюди потрапляють внутрішні домовленості вашої команди, найновіша мажорна версія фреймворку чи специфіка українського законодавства.
Типові збої тут такі:
- Застарілість. Модель упевнено радить API, який уже позначено як застарілий.
- Нерівномірне покриття. Про React вона знає набагато більше, ніж про нішевий фреймворк з кількома сотнями зірок на GitHub.
- Успадковані упередження. Те, що частіше траплялося в даних, модель вважає «стандартом» і «нормою».
- Неможливість назвати джерело. Модель не пам'ятає, звідки взяла конкретний факт, тож не може чесно на нього послатися.
Вебпошук, пошук по документах (RAG), підключення інструментів через MCP існують, щоб закрити ці прогалини: вони дають моделі доступ до інформації, якої не було в навчальних даних.
Ця властивість — основа делегування. Розуміючи, де модель «добре забезпечена» знаннями, а де вони тонкі, ви вирішуєте, що їй доручити, що треба додати в контекст самому, а з чим краще звернутися до документації чи колеги.
Робоча пам'ять
Модель бачить лише те, що вміщується в її контекстне вікно: системні інструкції, історію розмови, вставлені документи, результати інструментів. Усе поза вікном для неї не існує.
Зона можливостей — матеріал вільно вміщується, розмова свіжа, а потрібний контекст ви передали явно.
Зона обмежень — дуже довгі документи й розмови, очікування, що модель «пам'ятає» попередню сесію, і важлива інформація, загублена посеред великого обсягу тексту.
Тут працюють два різні механізми, і їх варто розрізняти.
Жорстка межа. Коли контекст переповнюється, старіші частини розмови відкидаються або стискаються. Часто це відбувається непомітно, і ви не отримаєте попередження про те, що модель більше не бачить домовленостей з початку діалогу.
М'яка деградація. Навіть усередині вікна модель використовує інформацію нерівномірно. Дослідження «Lost in the Middle» показало U-подібну залежність: те, що стоїть на початку і в кінці контексту, модель враховує найкраще, а все, що опинилося посередині, — помітно гірше. У деяких експериментах точність відповіді при потрібному документі в середині падала нижче, ніж коли модель узагалі не отримувала документів. Новіші моделі зменшили цей ефект, але повністю він не зник.
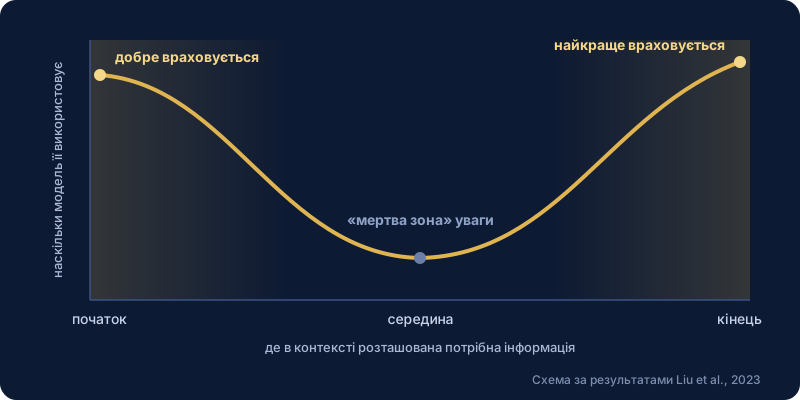
Ця картина нагадує ефект позиції в ряду з когнітивної психології: людина, яка запам'ятовує список слів, краще відтворює перші й останні, а середина випадає.
TIP
Розміщуйте найважливіші інструкції на початку і в кінці контексту. Якщо обмеження критичне, сформулюйте його на початку системного промпту і повторіть ближче до кінця.
Звідси випливає, що «просто дати більше контексту» — не завжди відповідь. Кожен доданий фрагмент відсуває інші в середину, у зону гіршої уваги. У цьому й полягає суть контекстної інженерії: важливо не лише що включити, а й де це розмістити і що залишити поза контекстом.
Ще одна важлива річ: модель не вчиться на ваших виправленнях. Вона реагує лише на те, що зараз є в контексті. Виправлення діє, поки залишається у вікні. Функції пам'яті між сесіями зберігають окремі нотатки і підставляють їх у контекст, але ваги моделі від цього не змінюються.
Пам'ять між сесіями, автоматичне стискання історії, проєкти зі спільними файлами, більші вікна й мультиагентні схеми існують для того, щоб відсунути жорстку межу. Але правило розміщення важливого працює незалежно від розміру вікна.
Робоча пам'ять — це те, з чим працює опис. Розуміючи, як влаштоване вікно, ви знаєте, як структурувати контекст, що винести на початок і коли варто почати нову розмову.
Керованість
Модель виконує інструкції тим самим механізмом передбачення наступного токена. Інструкція змінює те, яке продовження виглядає найімовірнішим, але не перетворюється на жорстке правило.
Зона можливостей — короткі, конкретні інструкції, виконання яких легко перевірити: формат відповіді, обмеження довжини, чітко задана роль.
Зона обмежень — довгі ланцюжки міркувань, абстрактні або неоднозначні вимоги і все, що потребує точних обчислень чи строгої логіки.
Тут трапляються два типові збої.
Дрейф міркувань. У довгому ланцюжку кожен крок спирається на попередній, тож дрібна помилка на третьому кроці до десятого стає великою. Модель при цьому не «помічає», що зійшла з курсу.
Буква замість духу. Інструкцію виконано формально, а мету ні. Ви просите скоротити технічний документ до 200 слів, а модель вирізає саме розділ з обмеженнями й ризиками, бо його легко викинути без шкоди для зв'язності тексту.
У другому випадку не допоможе повторити ту саму інструкцію з більшим натиском. Треба переформулювати мету: «скороти до 200 слів, але читач має зрозуміти, які ризики ми свідомо приймаємо». Інструкція каже моделі, що зробити, а мета — для чого.
Системні промпти, виконання коду замість обчислень «у голові», видимі міркування і режими структурованого виводу існують для того, щоб ваш намір не розмивався дорогою.
Керованість одночасно робить опис потужним і обмежує його. Розуміння розриву між словами й наміром змінює і те, як ви пишете промпти, і те, де ставите контрольні точки.
Діагностика: збої на перетині властивостей
На практиці помилка рідко пояснюється однією властивістю. Здебільшого діють дві одночасно, і саме їхня комбінація підказує виправлення.
| Симптом | Властивості | Що робити |
|---|---|---|
| Вигаданий параметр API, неіснуюча стаття чи цитата | Передбачення токена + знання | Перевіряти конкретику за першоджерелом |
| У довгій розмові модель «забула» домовленості з початку | Робоча пам'ять + керованість | Нагадати ключові вимоги або почати нову сесію |
| Помилка в підрахунках посеред довгого розв'язку | Керованість + передбачення токена | Винести обчислення в код |
| Модель погоджується з вашою хибною тезою | Сліди донавчання + передбачення токена | Прямо попросити заперечити або знайти слабкі місця |
Повернімося до прикладу зі вступу. Модель погано знає маловідому бібліотеку (знання), але все одно генерує найправдоподібніше продовження (передбачення токена). Вигадана назва параметра і посилання на документацію — саме та конкретика, яку треба перевіряти в першу чергу. Назвавши властивості, ви одразу отримуєте план: дати моделі справжню документацію в контекст або перевірити відповідь за нею.
Такий аналіз і є розрізненням на практиці. Оцінювати відповідь легше, коли знаєш, яку саме помилку шукаєш.
Відкалібрована довіра
Чотири властивості разом з фреймворком 4D утворюють одну систему. Властивості пояснюють, як поводиться модель, компетенції — як на це реагувати людині.
Відкалібрована довіра означає не «довіряти» чи «не довіряти» моделі загалом, а для кожного завдання визначити, де воно розташоване на кожній із чотирьох шкал, і відповідно до цього обрати, скільки контексту дати і наскільки ретельно перевіряти результат. Переформатувати JSON можна майже не перевіряючи. Цитату з закону, яку ви вставите в договір, треба перевірити до останньої коми.
Моделі змінюватимуться: вікна ростуть, з'являються нові інструменти, межі зон зсуваються. Але сама структура з чотирьох властивостей залишається корисною навіть тоді, коли конкретні межі зміщуються. А відповідальність за результат, тобто сумлінність, залишається за людиною за будь-якої моделі.
Що зробити наступного разу
Згадайте останній випадок, коли модель дала вам неправильну відповідь. Спробуйте назвати дві властивості, які в ньому перетнулися, і подумайте, яке виправлення з таблиці вище спрацювало б.
Потім зробіть одну зміну у своєму звичному робочому процесі. Наприклад, перевіряйте за першоджерелом кожну назву функції чи параметра, яку модель запропонувала для незнайомої бібліотеки. Або перенесіть ключові обмеження свого системного промпту на його початок і повторіть їх у кінці. Одна усвідомлена зміна дасть більше, ніж загальне рішення «бути уважнішим».